
システム障害の原因分類は、障害を技術・運用・外部などの軸で分け、再発防止の優先順位を決めるための作業です。分類の軸を先に決めておくと、障害報告書の書き方が揃い、1件ごとの障害が「次に何を直すか」の判断材料に変わります。
システム障害の原因分類|分類の観点と再発防止への使い方
この記事では、原因分類をする目的、代表的な分類の軸、障害報告書での整理方法、原因分析の手法、分類結果の活用、分析でつまずきやすい点を順に説明します。障害報告書や再発防止策をまとめる運用担当者が、自分の現場にそのまま当てはめられる形で書いています。障害そのものの基本や対応フローはシステム障害の発生要因と対応フローの基本で整理しています。
原因分類をする目的
原因分類の目的は、個々の障害を比較できる形にそろえ、再発防止の打ち手に優先順位をつけることです。障害報告書を1件ずつ書いて終わりにすると、障害同士のつながりが見えず、似た障害が別の担当者のもとで繰り返されます。
傾向の把握
原因を同じ軸で分類し続けると、障害が特定の領域に偏っているかどうかが数字で見えるようになります。
たとえば四半期ごとに障害を分類して件数を並べたとき、変更作業に起因するものが全体の過半を占めていれば、見直すべきは変更管理の手順です。設定ミスが続いているなら、手順書の整備や作業前のレビューに手を入れる判断ができます。分類が無ければ、各障害の報告書には「担当者の確認不足」「想定外の負荷」といった個別の言葉が並ぶだけで、全体の傾向は読み取れません。
再発防止の優先順位
再発防止策の優先順位は、分類ごとの発生件数と、1件あたりの影響の大きさを掛け合わせて決めると納得感が出ます。
対策に使える人手や予算には限りがあります。件数が多い分類でも1件の影響が小さければ、自動化で一括して減らす方法が向いています。件数が少なくても停止時間が長くなりやすい分類は、冗長化や切り戻し手順の整備を先に進める価値があります。重大度の決め方はシステム障害のレベル(重大度)定義の考え方とあわせて確認してください。
代表的な分類の軸
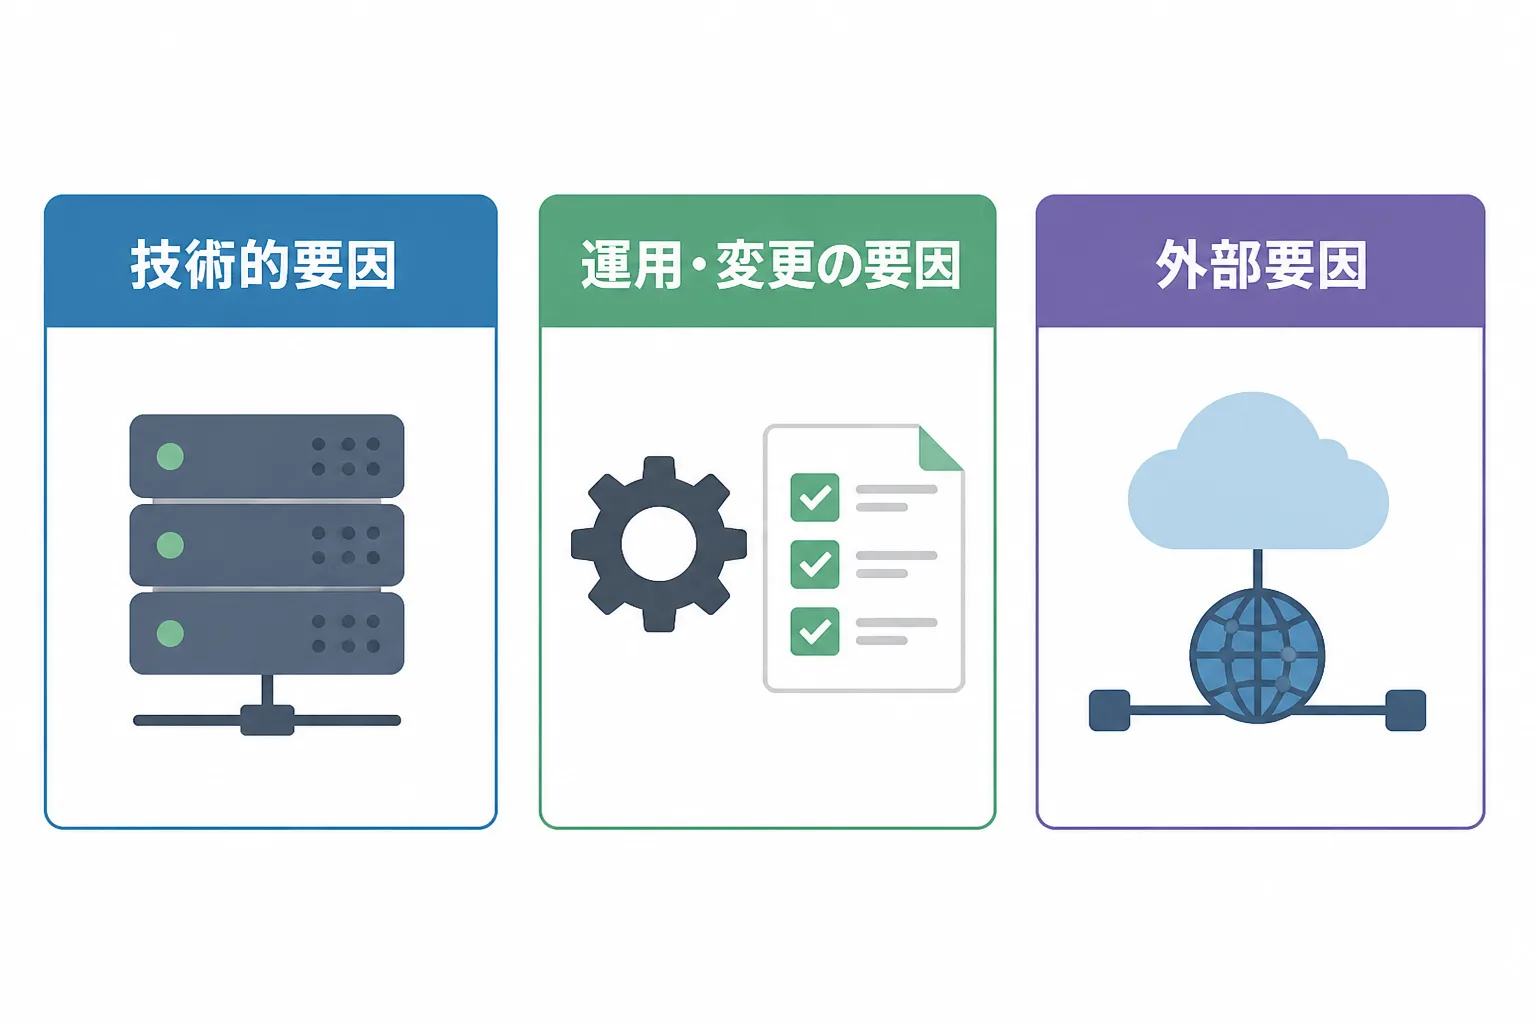
原因は、技術的要因、運用・変更の要因、外部要因の3つの軸で分けると、現場で運用しやすい分類になります。
情報処理推進機構(IPA)の資料「障害分析手法」では、システム障害の直接原因は大きくハードウェア障害、ソフトウェア障害、作業ミスの3つに分類されることが多いとされています。この3分類を実務で使いやすくするには、ハードウェアとソフトウェアを技術的要因にまとめ、作業ミスをその背景にある手順や体制とあわせて運用・変更の要因に置き、組織の外で起きる事象を外部要因として切り分けます。人の操作に関わる「人的要因」は、独立した軸にせず、運用・変更の要因の中で手順や体制の問題として扱うのが実務上は扱いやすいと考えます。
分類の軸 | 主な例 | 見分けるための問い |
|---|---|---|
技術的要因 | ハードウェア故障、ソフトウェアの不具合、性能・容量の不足、設計の欠陥 | 同じ条件で再現できるか。仕組みを変えれば防げるか |
運用・変更の要因 | 作業ミス、手順書の不備、変更管理の漏れ、監視設定の漏れ、引き継ぎの不足 | 人や手順が変われば防げたか。作業前に確認する仕組みがあったか |
外部要因 | クラウド・通信事業者の障害、委託先や外部サービスの停止、アクセスの急増、サイバー攻撃、停電や災害 | 自社の管理範囲の外で起きたか。影響を小さくする備えはあったか |
技術的要因
技術的要因は、機器やソフトウェアそのものの欠陥や限界に原因がある障害です。
ハードウェアの故障や劣化、ソフトウェアの不具合、データ量の増加に処理能力が追いつかない性能・容量の不足、そもそもの設計の欠陥などが含まれます。判断の目安は、同じ条件で障害を再現できるかどうかです。再現できるなら、設定や運用ではなく仕組みの側に原因がある可能性が高くなります。再発防止は、冗長化、容量計画の見直し、テスト範囲の拡大など、仕組みを変える対策が中心になります。
運用・変更の要因
運用・変更の要因は、日々の作業や変更の進め方に原因がある障害で、現場で最も多く記録される分類です。
手順書にない作業の実施、設定値の入力ミス、変更内容のレビュー漏れ、監視項目の設定漏れ、担当交代時の引き継ぎ不足などが該当します。作業ミスは「人が間違えた」で終わらせず、間違えやすい手順だったのか、確認する仕組みが無かったのかまで掘り下げて分類します。編集部の見方として、障害報告書の分類欄に「人為ミス」とだけ書かれた記録は、再発防止策に結びつきにくく、運用・変更の要因の中で「手順」「確認体制」「教育」のどこに当たるかまで書き分けた記録のほうが、次の対策を決めやすくなります。
外部要因
外部要因は、自社の管理範囲の外で起きた事象に原因がある障害です。
クラウドや通信事業者の障害、委託先・外部サービスの停止、想定を超えるアクセスの集中、サイバー攻撃、停電や災害が代表例です。ただし、外部要因に分類して終わりにしてはいけません。IPAの同じ資料では、障害の背景を探る観点として「エラーはなぜ発生したか」に加えて「エラー拡大阻止はなぜ失敗したか」が挙げられています。外部で起きたエラーに対しても、自社側に冗長構成や縮退運転、代替手段の備えがあったかを確認すれば、運用・変更の要因や技術的要因として別に分類できる原因が見つかることがあります。
障害報告書での整理方法
障害報告書は、事実、原因、対策を別の欄に分けて書くと、そのまま原因分類に使える記録になります。
事実と原因の分け方
事実は「観測できたこと」、原因は「事実から導いた推論」として別々に書くのが基本です。
事実には、時刻、画面やログに出たメッセージ、実施した作業、影響を受けた機能のように、第三者が確認できる内容だけを書きます。「負荷が高かったため遅延した」のような因果の説明は、原因の欄に回します。両者が混ざった報告書は、後から読み返したときに推測と記録の区別がつかず、分類の根拠も曖昧になります。
次の表は、架空の月末バッチ遅延を例に、事実・原因・分類を分けて書いた記載例です。
項目 | 事実(観測できたこと) | 原因(推論) | 分類 |
|---|---|---|---|
事象 | 月末の売上集計バッチが、通常2時間のところ6時間かかった | データ件数の増加に対し、集計対象の検索に必要な索引が整備されていなかった | 技術的要因(性能・容量) |
変更 | 前日に実施した設定変更が、手順書に反映されていなかった | 変更後の手順書を更新する工程が、変更管理の手順に含まれていなかった | 運用・変更の要因 |
検知 | 遅延に気づいたのは、開始から3時間後の問い合わせだった | バッチの実行時間に対する監視の閾値が設定されていなかった | 運用・変更の要因(拡大阻止の失敗) |
1つの障害から複数の行が出るのは自然なことです。行ごとに分類を付けておけば、集計のときに「主因」と「寄与要因」を分けて数えられます。
影響範囲の書き方
影響範囲は、対象システム、対象ユーザー、期間、業務への影響の4項目で、できるだけ数値を使って書きます。
- 対象システム:停止または劣化した機能名(例:受注入力、帳票出力)
- 対象ユーザー:影響を受けた部門や利用者数、顧客の有無
- 期間:開始時刻、復旧時刻、影響があった合計時間
- 業務への影響:遅延した処理件数、手作業で代替した業務、金銭的な影響の有無
確認できていない数値は、断定せず「推定」と明記して書きます。あとから数値が変わった場合に、どの時点の情報かが分かるよう、記載日時も添えておくと読み手が迷いません。影響の大きさを段階に分ける考え方は、重大度の定義とあわせて整理すると報告書の読み手に伝わります。
原因分析の手法
原因分析は、事実を時系列で並べてから、なぜなぜ分析で根本原因まで遡る順序が実務で使いやすい進め方です。
なぜなぜ分析
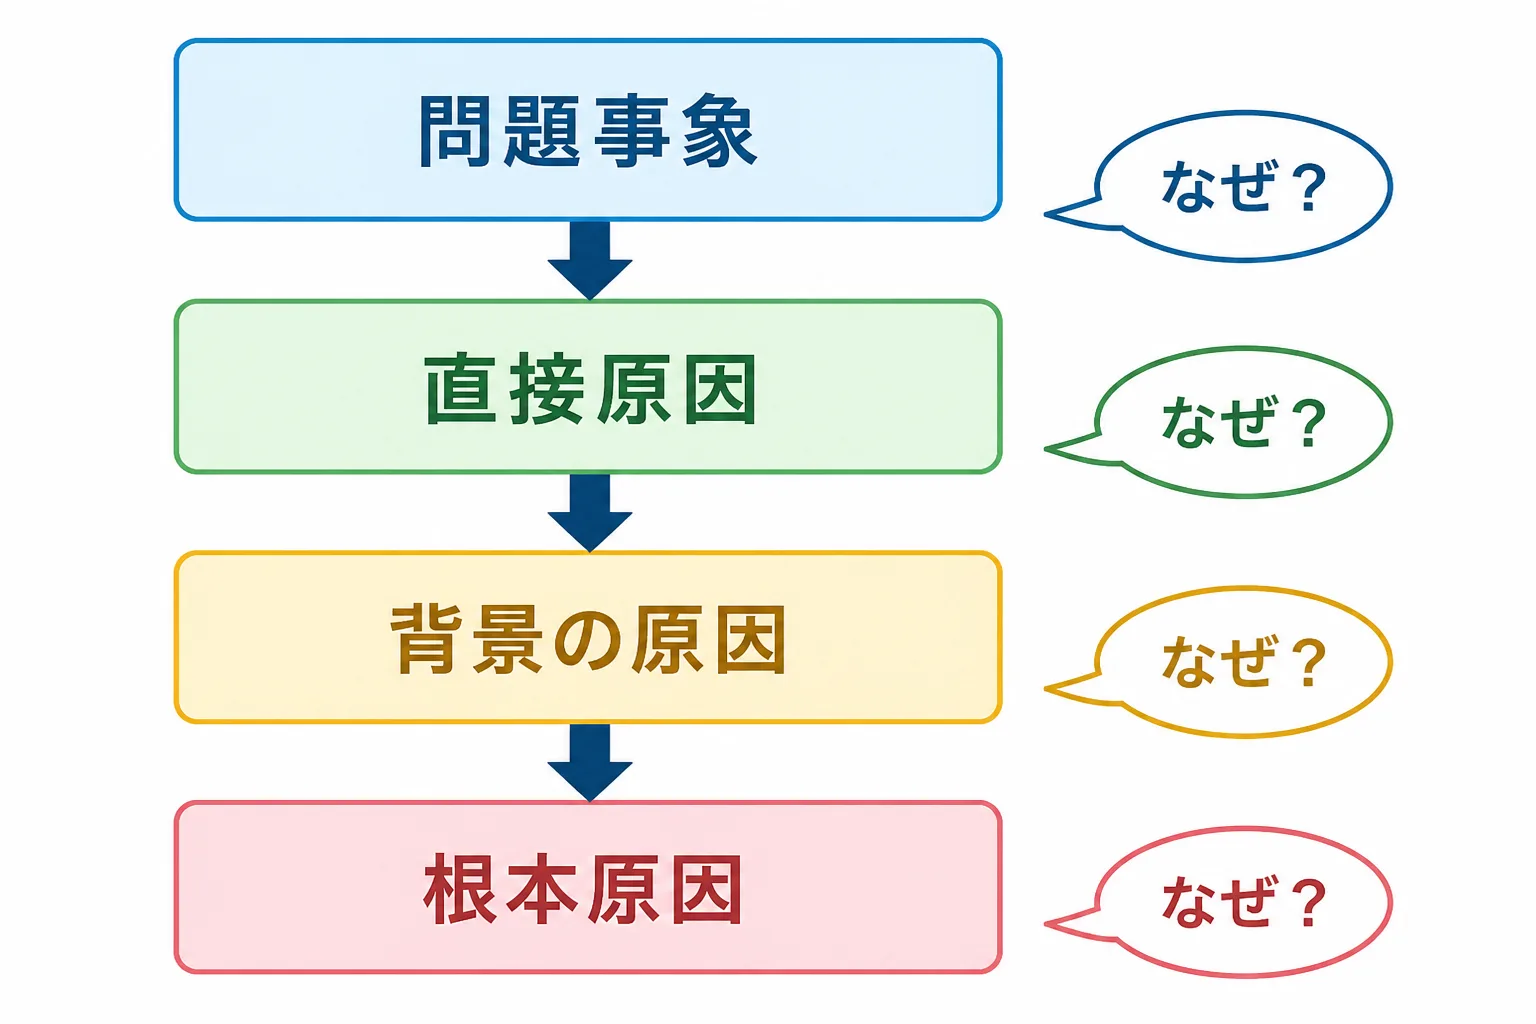
なぜなぜ分析は、問題事象を起点に「なぜ」を繰り返し、対策すれば再発しなくなる根本原因まで遡る手法です。
IPAの資料では、問題事象を発生させた直接の原因を見つけ、さらにその直接原因を引き起こした原因を見つける手順をくり返して、本質的な原因を見つけ出すと説明されています。進め方は次の4段階です。
- 問題事象を、観測できた事実として1文で書きます(例:月末バッチが6時間かかった)
- その事象を直接起こした原因を書きます(例:集計対象の検索が遅かった)
- その原因が生じた理由を、「なぜ」を繰り返して掘り下げます(例:索引が無かった、索引の要否を確認する工程が無かった)
- 対策を打てる地点まで来たら止め、そこを根本原因とします(例:設計レビューに性能確認が含まれていなかった)
分析は事実をもとに実施し、可能であれば障害に関わった当事者にも参加してもらうことが望ましいとされています。要因の洗い出しの漏れを防ぐ枠組みとして、同じ資料はm-SHELモデルを使う方法も紹介しています。
時系列の整理
時系列は、発生、検知、対応、復旧の4つの区間に分けて、時刻を並べて整理します。
時刻は24時間表記で統一し、ログの時刻とシステムごとのタイムゾーンをそろえてから並べます。区間ごとの長さを見ると、改善すべき場所が分かれます。発生から検知までが長ければ監視や通知の設計、検知から対応の開始までが長ければ連絡体制や当番の仕組み、対応開始から復旧までが長ければ手順書や切り戻しの準備が課題です。この区間の見方は、そのまま原因分類の補助情報になります。
分類結果の活用
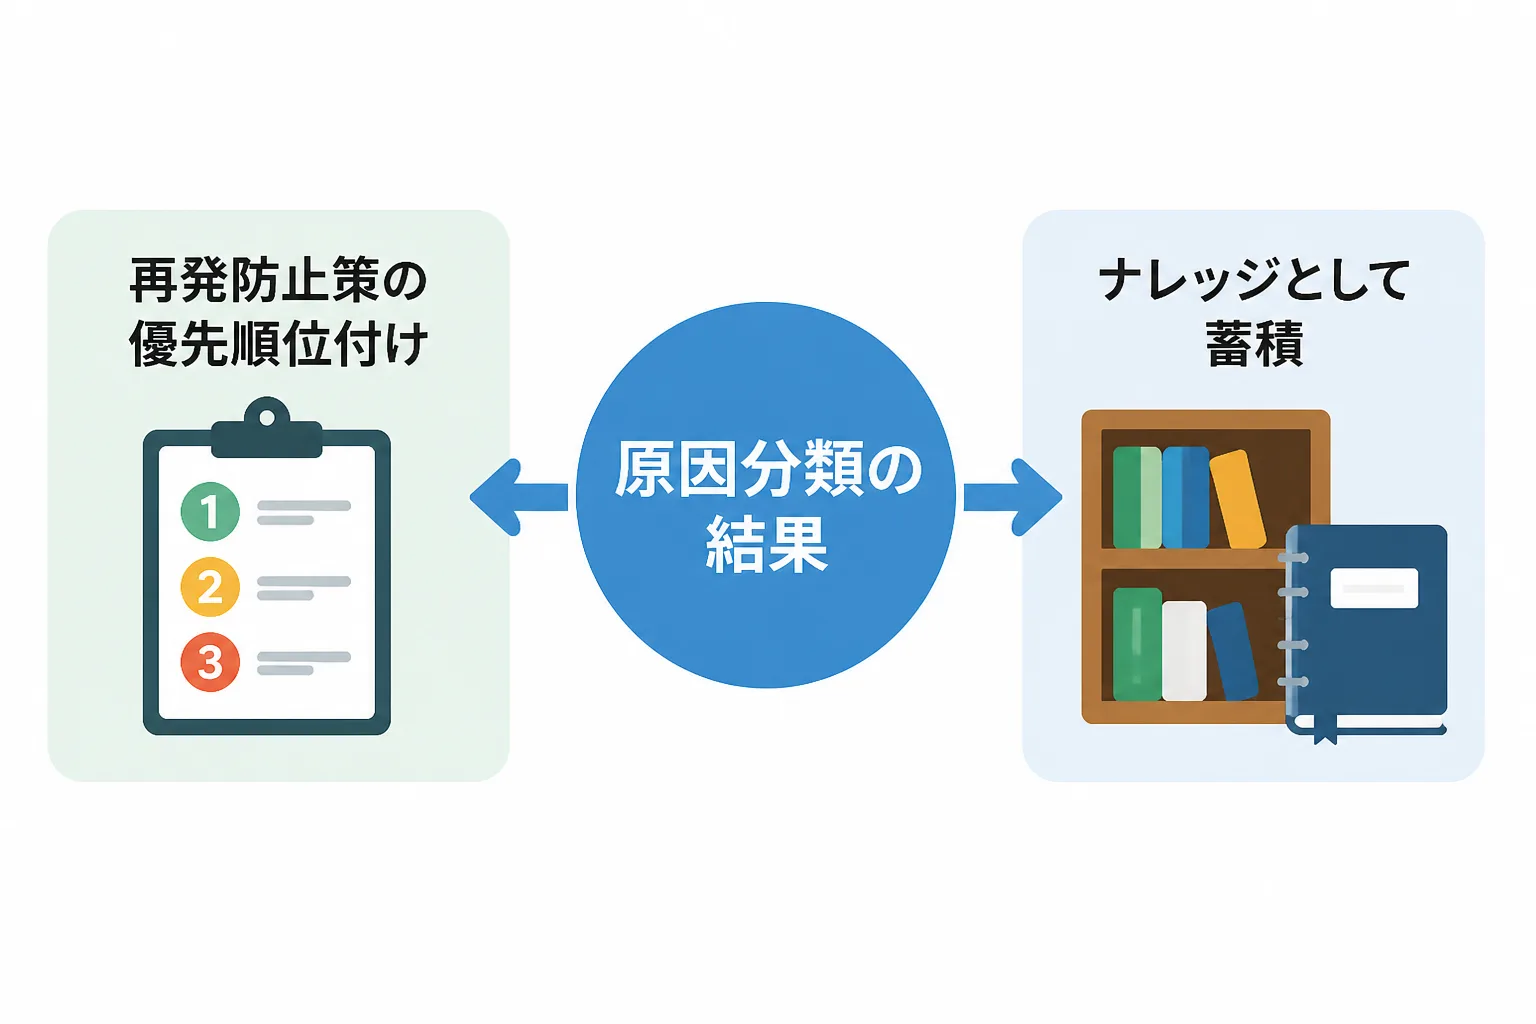
分類結果は、再発防止策の優先順位づけと、次の担当者が使えるナレッジの2つに使います。
再発防止策の優先順位付け
再発防止策の優先順位は、発生頻度、影響の大きさ、対策のしやすさの3つの観点で付けます。
分類ごとに、対策の方向性は次のように変わります。
- 技術的要因:冗長化、容量計画の見直し、テスト範囲の拡大、監視の追加
- 運用・変更の要因:手順書の整備、変更前のレビュー、作業の自動化、引き継ぎ項目の標準化
- 外部要因:契約や提供条件の確認、代替手段と切り替え手順の整備、影響を小さくする縮退運転の設計
発生頻度が高く、手順書の修正のように短期間で終わる対策から着手し、設計変更を伴う対策は計画に載せて段階的に進めます。進捗の管理や関係者の調整は、プロジェクトを横断して支えるPMOの役割とも重なる部分があります。
ナレッジとして蓄積
障害の記録は、分類、症状、原因、対策を同じ項目で残すと、あとから検索できるナレッジになります。
IPAの「情報処理システム高信頼化教訓集(ITサービス編)」は、ガバナンス/マネジメント領域21件、技術領域33件の計54件の教訓を、問題、原因、対策、効果、教訓の順に整理しています。自社の記録でも、この並びに分類欄を加えておくと、似た障害が起きたときに過去の対策をすぐ引き出せます。記録のたびに項目が変わると検索に使えないため、書式は固定します。
原因分類の結果を、設計や運用ルールの改善提案として示せるようになると、運用を担う立場から、上流の改善に関わる立場へと役割が広がります。公開されている相場情報でも、上流フェーズの案件は下流の運用・保守よりも高単価とされ、IT戦略領域の月額単価は150〜200万円の水準が示されています(bizdev-tech、2026年時点)。独立後の単価の見え方はPMOフリーランスの単価相場や、フリーコンサル向けエージェントの比較でも確認できます。
分析でつまずく点
つまずきやすいのは、原因を個人の責任に帰着させてしまうことと、原因が複数ある障害を1つに絞ってしまうことです。
個人の責任にしない
作業ミスは「誰がしたか」ではなく「なぜ防げなかったか」まで掘り下げると、組織として打てる対策になります。
IPAの資料でも、分析の目的は障害を発生させた個人を責めることではなく、原因を究明して組織としての再発防止策を検討することだと参加者に徹底するよう述べられています。たとえば「担当者Aの入力ミス」という原因は、「入力値を確認する仕組みが無かった」「二重確認が手順に含まれていなかった」と言い換えられます。後者であれば、チェック機能の追加や手順の変更という具体的な対策につながります。個人名を原因欄に書かない運用にしておくと、当事者が事実を話しやすくなり、分析の精度も上がります。
原因が複数ある場合
原因が複数ある場合は、主因と寄与要因に分けて、それぞれに分類を付けます。
障害は、1つの原因だけで起きるとは限りません。月末バッチの例のように、性能の不足(技術的要因)に、手順書の更新漏れと監視の不備(運用・変更の要因)が重なって影響が大きくなることがあります。そのため、「エラーはなぜ発生したか」と「エラー拡大阻止はなぜ失敗したか」を別々に分析して記録します。集計するときは、主因で1件と数え、寄与要因は別の列で数える運用にすると、件数が二重に膨らまず、対策の抜けも見つけやすくなります。
原因分類は、分類の軸を決め、事実と原因を分けて記録し、結果を再発防止策とナレッジに戻すところまでで一巡します。軸を増やしすぎず、同じ書式で続けることが、傾向を見つけやすくする近道です。
出典・参考情報
- 独立行政法人情報処理推進機構(IPA)「別冊Ⅱ:障害分析手法」(2020年3月16日改訂)(2026-10-08参照)
- 独立行政法人情報処理推進機構(IPA)「情報処理システム高信頼化教訓集 ITサービス編」(2026-10-08参照)
- bizdev-tech「26年版 フリーランスコンサルタントの年収ガイド」(2026-10-08参照)
最終更新日:2026年10月8日。本記事は2026年10月時点の公開情報にもとづく一般的な整理であり、個別のシステムや契約に関する判断は、自社の規程や専門家にご確認ください。
Powered by Proconnect
PMO・DX・SAP系コンサルタント案件を無料で探してみる
スキルシートを登録するだけ。専任エージェントが最適な案件を無料でご提案します。
無料でコンサルタント案件を探す